Converters e codecs
Aprenda como escrever conversões eficientes.
Escrito por Florian Loitsch
Fevereiro de 2014 (atualizado em Março de 2015)
Converter dados entre diferentes representações é uma tarefa comum em engenharia de computação. Dart não é exceção e vem com dart:convert, uma biblioteca central que fornece um conjunto de converters e ferramentas úteis para construir novos converters. Exemplos de converters fornecidos pela biblioteca incluem aqueles para codificações comumente usadas como JSON e UTF-8. Neste documento, mostramos como os converters do Dart funcionam e como você pode criar seus próprios converters eficientes que se encaixam no mundo Dart.
Visão geral
#A arquitetura de conversão do Dart é baseada em converters, que traduzem de uma representação para outra. Quando conversões são reversíveis, dois converters são agrupados em um codec (coder-decoder). O termo codec é frequentemente usado para processamento de áudio e vídeo, mas também se aplica a codificações de string como UTF-8 ou JSON.
Por convenção, todos os converters no Dart usam as abstrações fornecidas na biblioteca dart:convert. Isso fornece uma API consistente para desenvolvedores e garante que os converters possam trabalhar juntos. Por exemplo, converters (ou codecs) podem ser fundidos se seus tipos correspondem, e o converter resultante pode então ser usado como uma única unidade. Além disso, esses converters fundidos frequentemente funcionam de forma mais eficiente do que se tivessem sido usados separadamente.
Codec
#Um codec é uma combinação de dois converters onde um codifica e o outro decodifica:
abstract class Codec<S, T> {
const Codec();
T encode(S input) => encoder.convert(input);
S decode(T encoded) => decoder.convert(encoded);
Converter<S, T> get encoder;
Converter<T, S> get decoder;
Codec<S, dynamic> fuse(Codec<T, dynamic> other) { .. }
Codec<T, S> get inverted => ...;
}
Como pode ser visto, codecs fornecem métodos de conveniência como encode() e
decode() que são expressos em termos do encoder e decoder. O método
fuse()
e o getter inverted permitem que você funda converters e
mude a direção de um codec, respectivamente.
A implementação base de
Codec
para esses dois membros
fornece uma implementação padrão sólida
e implementadores geralmente não precisam se preocupar com eles.
Os métodos encode() e decode()
também podem ser deixados intocados, mas podem ser estendidos para argumentos adicionais. Por exemplo, o
JsonCodec
adiciona argumentos nomeados a encode() e decode()
para tornar esses métodos mais úteis:
dynamic decode(String source, {reviver(var key, var value)}) { … }
String encode(Object value, {toEncodable(var object)}) { … }
O codec pode ser instanciado com argumentos que são usados como valores
padrão, a menos que sejam substituídos pelos argumentos nomeados durante a
chamada de encode()/decode().
const JsonCodec({reviver(var key, var value), toEncodable(var object)})
  ...
Como regra geral: se um codec pode ser configurado, ele deve adicionar argumentos nomeados
aos métodos encode()/decode() e permitir que seus padrões sejam
definidos em construtores.
Quando possível, construtores de codec devem ser construtores const.
Converter
#
Converters, e em particular seus métodos convert(), são
onde as conversões reais acontecem:
T convert(S input); // where T is the target and S the source type.
Uma implementação mínima de converter só precisa estender a
classe Converter
e
implementar o método convert(). Similar à classe Codec, converters podem ser
tornados configuráveis estendendo os construtores e adicionando argumentos nomeados ao
método convert().
Tal converter mínimo funciona em configurações síncronas, mas
não funciona quando usado com chunks (seja síncrona ou assincronamente). Em
particular, tal converter simples não funciona como um transformer (uma das
características mais agradáveis dos Converters). Um converter totalmente implementado implementa a
interface StreamTransformer
e pode assim ser dado ao método Stream.transform().
Provavelmente o caso de uso mais comum é a decodificação de UTF-8 com utf8.decoder:
File.openRead().transform(utf8.decoder).
Conversão em chunks
#O conceito de conversões em chunks pode ser confuso, mas em sua essência, é relativamente simples. Quando uma conversão em chunks (incluindo uma transformação de stream) é iniciada, o método startChunkedConversion do converter é invocado com um output- sink como argumento. O método então retorna um input sink no qual o chamador coloca dados.
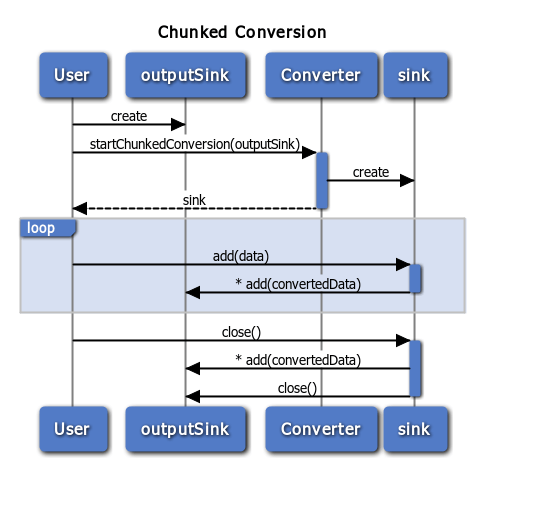
Nota: Um asterisco (*) no diagrama representa múltiplas chamadas opcionais.
No diagrama, o primeiro passo consiste em criar um outputSink que deve
ser preenchido com os dados convertidos. Então, o usuário invoca o
método startChunkedConversion() do converter com o output sink.
O resultado é um input sink com métodos add() e close().
Em um ponto posterior, o código que iniciou a conversão em chunks invoca,
possivelmente múltiplas vezes, o método add() com
alguns dados. Os dados são convertidos pelo input sink. Se os dados convertidos estão
prontos, o input sink os envia para o output sink, possivelmente com múltiplas
chamadas de add(). Eventualmente, o usuário finaliza a conversão invocando
close(). Neste ponto, quaisquer dados convertidos restantes são enviados do input
sink para o output sink e o output sink é fechado.
Dependendo do converter, o input sink pode precisar bufferizar partes dos
dados de entrada. Por exemplo, um line-splitter que recebe ab\ncd como o primeiro
chunk pode seguramente invocar seu output sink com ab, mas precisa esperar pelos
próximos dados (ou a chamada de close()) antes de poder manipular cd. Se os próximos dados forem
e\nf, o input sink deve concatenar cd e e
e invocar o output sink
com a string cde, enquanto bufferiza f para o próximo evento de dados (ou a
chamada de close()).
A complexidade do input sink (em combinação com o converter) varia.
Algumas conversões em chunks são trivialmente mapeadas para as versões não-chunked (como
um converter String→String que remove o caractere a), enquanto outras são
mais complicadas. Uma maneira segura, embora ineficiente (e geralmente não recomendada)
de implementar a conversão em chunks é bufferizar e concatenar todos os
dados de entrada e fazer a conversão de uma vez. É assim que o decoder JSON
está atualmente (Janeiro de 2014) implementado.
Curiosamente, o tipo de conversão em chunks não pode ser extrapolado de sua
conversão síncrona. Por exemplo, o
converter HtmlEscape
sincronamente
converte Strings para Strings, e assincronamente converte chunks de Strings para
chunks de Strings (String→String). O
converter LineSplitter
sincronamente
converte Strings para List
import 'dart:convert';
import 'dart:async';
void main() async {
// HtmlEscape synchronously converts Strings to Strings.
print(const HtmlEscape().convert("foo")); // "foo".
// When used in a chunked way it converts from Strings
// to Strings.
var stream = new Stream.fromIterable(["f", "o", "o"]);
print(await (stream.transform(const HtmlEscape())
.toList())); // ["f", "o", "o"].
// LineSplitter synchronously converts Strings to Lists of String.
print(const LineSplitter().convert("foo\nbar")); // ["foo", "bar"]
// However, asynchronously it converts from Strings to Strings (and
// not Lists of Strings).
var stream2 = new Stream.fromIterable(["fo", "o\nb", "ar"]);
print("${await (stream2.transform(const LineSplitter())
.toList())}");
}
Em geral, o tipo da conversão em chunks é determinado pelo caso mais útil quando usado como um StreamTransformer.
ChunkedConversionSink
#
ChunkedConversionSinks
são usados para adicionar novos dados a um
converter ou como saída de converters. O ChunkedConversionSink básico vem
com dois métodos: add() e close(). Estes têm a mesma funcionalidade que em
todos os outros sinks do sistema, como
StringSinks
ou
StreamSinks.
A semântica dos ChunkedConversionSinks é similar à dos IOSinks: dados adicionados ao sink não devem ser modificados a menos que possa ser garantido que os dados foram manipulados. Para Strings isso não é um problema (já que são imutáveis), mas para listas de bytes frequentemente significa alocar uma cópia nova da lista. Isso pode ser ineficiente e a biblioteca dart:convert assim vem com subclasses de ChunkedConversionSink que suportam maneiras mais eficientes de passar dados.
Por exemplo, o ByteConversionSink, tem o método adicional:
void addSlice(List<int> chunk, int start, int end, bool isLast);
Semanticamente, ele
aceita uma lista (que não pode ser mantida), o sub-intervalo no qual o converter
opera, e um boolean isLast, que pode ser definido em vez de chamar
close().
import 'dart:convert';
void main() {
var outSink = new ChunkedConversionSink.withCallback((chunks) {
print(chunks.single); // 𝅘𝅥𝅯
});
var inSink = utf8.decoder.startChunkedConversion(outSink);
var list = [0xF0, 0x9D];
inSink.addSlice(list, 0, 2, false);
// Since we used `addSlice` we are allowed to reuse the list.
list[0] = 0x85;
list[1] = 0xA1;
inSink.addSlice(list, 0, 2, true);
}
Como usuário do chunked conversion sink (que é usado tanto como entrada quanto saída
de converters), isso simplesmente fornece mais escolha. O fato de que a lista não é
mantida, significa que você pode usar um cache e reutilizar aquele para cada chamada.
Combinar add() com close() pode ajudar o receptor em que ele pode evitar
bufferizar dados. Aceitar sub-listas evita chamadas caras a subList()
(para copiar os dados).
A desvantagem dessa interface é que é mais complicado implementar. Para aliviar a dor dos desenvolvedores, cada chunked conversion sink melhorado de dart:convert também vem com uma classe base que implementa todos os métodos exceto um (que é abstrato). O implementador do conversion sink pode então decidir se deve aproveitar os métodos adicionais.
Nota: Chunked conversion sinks devem estender a classe base correspondente. Isso assegura que adicionar funcionalidade às interfaces de sink existentes não quebra os sinks estendidos.
Exemplo
#Esta seção mostra todos os passos necessários para criar um converter de encriptação simples e como um ChunkedConversionSink personalizado pode melhorar o desempenho.
Vamos começar com o converter síncrono simples, cuja rotina de encriptação simplesmente rotaciona bytes pela chave fornecida:
import 'dart:convert';
/// A simple extension of Rot13 to bytes and a key.
class RotConverter extends Converter<List<int>, List<int>> {
final _key;
const RotConverter(this._key);
List<int> convert(List<int> data, { int key }) {
if (key == null) key = this._key;
var result = new List<int>(data.length);
for (int i = 0; i < data.length; i++) {
result[i] = (data[i] + key) % 256;
}
return result;
}
}
A classe Codec correspondente também é simples:
class Rot extends Codec<List<int>, List<int>> {
final _key;
const Rot(this._key);
List<int> encode(List<int> data, { int key }) {
if (key == null) key = this._key;
return new RotConverter(key).convert(data);
}
List<int> decode(List<int> data, { int key }) {
if (key == null) key = this._key;
return new RotConverter(-key).convert(data);
}
RotConverter get encoder => new RotConverter(_key);
RotConverter get decoder => new RotConverter(-_key);
}
Podemos (e devemos) evitar algumas das alocações new, mas para simplicidade
alocamos uma nova instância de RotConverter toda vez que uma é necessária.
É assim que usamos o codec Rot:
const Rot ROT128 = const Rot(128);
const Rot ROT1 = const Rot(1);
void main() {
print(const RotConverter(128).convert([0, 128, 255, 1])); // [128, 0, 127, 129]
print(const RotConverter(128).convert([128, 0, 127, 129])); // [0, 128, 255, 1]
print(const RotConverter(-128).convert([128, 0, 127, 129]));// [0, 128, 255, 1]
print(ROT1.decode(ROT1.encode([0, 128, 255, 1]))); // [0, 128, 255, 1]
print(ROT128.decode(ROT128.encode([0, 128, 255, 1]))); // [0, 128, 255, 1]
}
Estamos no caminho certo. O codec funciona, mas ainda está faltando a parte de codificação em chunks. Como cada byte é codificado separadamente, podemos recorrer ao método de conversão síncrono:
class RotConverter {
...
RotSink startChunkedConversion(sink) {
return new RotSink(_key, sink);
}
}
class RotSink extends ChunkedConversionSink<List<int>> {
final _converter;
final ChunkedConversionSink<List<int>> _outSink;
RotSink(key, this._outSink) : _converter = new RotConverter(key);
void add(List<int> data) {
_outSink.add(_converter.convert(data));
}
void close() {
_outSink.close();
}
}
Agora, podemos usar o converter com conversões em chunks ou até mesmo para transformações de stream:
import 'dart:io';
void main(List<String> args) {
String inFile = args[0];
String outFile = args[1];
int key = int.parse(args[2]);
new File(inFile)
.openRead()
.transform(new RotConverter(key))
.pipe(new File(outFile).openWrite());
}
ChunkedConversionSinks Especializados
#Para muitos propósitos, a versão atual de Rot é suficiente. Ou seja, o benefício das melhorias seria superado pelo custo de código mais complexo e requisitos de teste. Vamos supor, no entanto, que o desempenho do converter é crítico (está no hot path e aparece no profile). Além disso, assumimos que o custo de alocar uma nova lista para cada chunk está prejudicando o desempenho (uma suposição razoável).
Começamos tornando o custo de alocação mais barato: usando uma lista tipada de bytes podemos reduzir o tamanho da lista alocada por um fator de 8 (em máquinas de 64 bits). Esta mudança de uma linha não remove a alocação, mas a torna muito mais barata.
Também podemos evitar a alocação completamente se sobrescrevermos a entrada. Na
seguinte versão de RotSink, adicionamos um novo método addModifiable()
que
faz exatamente isso:
class RotSink extends ChunkedConversionSink<List<int>> {
final _key;
final ChunkedConversionSink<List<int>> _outSink;
RotSink(this._key, this._outSink);
void add(List<int> data) {
addModifiable(new Uint8List.fromList(data));
}
void addModifiable(List<int> data) {
for (int i = 0; i < data.length; i++) {
data[i] = (data[i] + _key) % 256;
}
_outSink.add(data);
}
void close() {
_outSink.close();
}
}
Para simplicidade, propomos um novo método que consome uma lista completa. Um
método mais avançado (por exemplo addModifiableSlice()) pegaria argumentos de intervalo
(from, to) e um boolean isLast como argumentos.
Este novo método ainda não é usado por transformers, mas já podemos usá-lo quando
invocamos startChunkedConversion() explicitamente.
void main() {
  var outSink = new ChunkedConversionSink.withCallback((chunks) {
    print(chunks); // [[31, 32, 33], [24, 25, 26]]
  });
  var inSink = new RotConverter(30).startChunkedConversion(outSink);
  inSink.addModifiable([1, 2, 3]);
  inSink.addModifiable([250, 251, 252]);
  inSink.close();
}
Neste pequeno exemplo, o desempenho não é visivelmente diferente, mas internamente a conversão em chunks evita alocar novas listas para os chunks individuais. Para dois chunks pequenos, não faz diferença, mas se implementarmos isso para o stream transformer, encriptar um arquivo maior pode ser notavelmente mais rápido.
Para fazer isso,
podemos fazer uso do recurso não documentado de que IOStreams fornecem listas modificáveis.
Poderíamos agora simplesmente reescrever add() e
apontá-lo diretamente para addModifiable(). Em geral, isso não é seguro,
e
tal converter seria a fonte potencial de bugs difíceis de rastrear. Em vez disso,
escrevemos um converter que faz a conversão de não-modificável para modificável
explicitamente, e então fundimos os dois converters.
class ToModifiableConverter extends Converter<List<int>, List<int>> {
List<int> convert(List<int> data) => data;
ToModifiableSink startChunkedConversion(RotSink sink) {
return new ToModifiableSink(sink);
}
}
class ToModifiableSink
extends ChunkedConversionSink<List<int>, List<int>> {
final RotSink sink;
ToModifiableSink(this.sink);
void add(List<int> data) { sink.addModifiable(data); }
void close() { sink.close(); }
}
ToModifiableSink apenas sinaliza ao próximo sink que o chunk de entrada é modificável. Podemos usar isso para tornar nosso pipeline mais eficiente:
void main(List<String> args) {
  String inFile = args[0];
  String outFile = args[1];
  int key = int.parse(args[2]);
  new File(inFile)
      .openRead()
      .transform(
          new ToModifiableConverter().fuse(new RotConverter(key)))
      .pipe(new File(outFile).openWrite());
}
Na minha máquina, esta pequena modificação trouxe o tempo de encriptação de um arquivo de 11MB
de 450ms para 260ms. Conseguimos esta aceleração sem perder
compatibilidade com codecs existentes (com relação ao método fuse())
e o converter ainda funciona como um stream transformer.
Reutilizar a entrada funciona muito bem com outros
converters e não apenas com nossa cifra Rot. Devemos portanto fazer uma
interface que generalize o conceito. Para simplicidade, nós a nomeamos
CipherSink, embora tenha, é claro, usos fora do mundo da encriptação.
abstract class CipherSink
    extends ChunkedConversionSink<List<int>, List<int>> {
  void addModifiable(List<int> data) { add(data); }
}
Podemos então tornar nosso RotSink privado e expor o CipherSink em vez disso. Outros desenvolvedores podem agora reutilizar nosso trabalho (CipherSink e ToModifiableConverter) e se beneficiar dele.
Mas ainda não terminamos.
Embora não vamos tornar a cifra mais rápida, podemos melhorar o lado de saída do nosso converter Rot. Pegue, por exemplo, a fusão de duas encriptações:
void main(List<String> args) {
  String inFile = args[0];
  String outFile = args[1];
  int key = int.parse(args[2]);
  // Double-strength cipher running the Rot-cipher twice.
  var transformer = new ToModifiableConverter()
       .fuse(new RotConverter(key))  // <= fused RotConverters.
       .fuse(new RotConverter(key));
  new File(inFile)
      .openRead()
      .transform(transformer)
      .pipe(new File(outFile).openWrite());
}
Como o primeiro RotConverter invoca outSink.add(), o segundo RotConverter
assume que a entrada não pode ser modificada e aloca uma cópia. Podemos contornar
isso colocando um ToModifiableConverter entre as duas cifras:
  var transformer = new ToModifiableConverter()
       .fuse(new RotConverter(key))
       .fuse(new ToModifiableConverter())
       .fuse(new RotConverter(key));
Isso funciona, mas é hackish. Queremos que os RotConverters funcionem sem converters intermediários. A primeira cifra deve olhar para o outSink e determinar se é um CipherSink ou não. Podemos fazer isso, sempre que queremos adicionar um novo chunk, ou no início quando iniciamos uma conversão em chunks. Preferimos a última abordagem:
  /// Works more efficiently if given a CipherSink as argument.
  CipherSink startChunkedConversion(
      ChunkedConversionSink<List<int>> sink) {
    if (sink is! CipherSink) sink = new _CipherSinkAdapter(sink);
    return new _RotSink(_key, sink);
  }
_CipherSinkAdapter é simplesmente:
class _CipherSinkAdapter implements CipherSink {
ChunkedConversionSink<List<int>, List<int>> sink;
_CipherSinkAdapter(this.sink);
void add(data) { sink.add(data); }
void addModifiable(data) { sink.add(data); }
void close() { sink.close(); }
}
Agora só precisamos mudar o _RotSink para aproveitar o fato de que ele sempre recebe um CipherSink como argumento para seu construtor:
class _RotSink extends CipherSink {
final _key;
final CipherSink _outSink; // <= always a CipherSink.
_RotSink(this._key, this._outSink);
void add(List<int> data) {
addModifiable(data.toList());
}
void addModifiable(List<int> data) {
for (int i = 0; i < data.length; i++) {
data[i] = (data[i] + _key) % 256;
}
_outSink.addModifiable(data); // <= safe to call addModifiable.
}
void close() {
_outSink.close();
}
}
Com essas mudanças, nossa cifra dupla super segura não alocará nenhuma nova lista e nosso trabalho está feito.
Agradecimentos a Lasse Reichstein Holst Nielsen, Anders Johnsen e Matias Meno que foram de grande ajuda na escrita deste artigo.
Salvo indicação em contrário, a documentação neste site reflete Dart 3.13.7. Página atualizada pela última vez em 2026-11-12. Ver código-fonte ou relatar um problema.
Encontrou essa página sem tradução ou que precisa de correção? Abra uma issue e nos ajude a manter esse site em PT-BR para ajudar pessoas como você.