Dart DevTools: analisando o desempenho de aplicações com o CPU Profiler
Seja você um desenvolvedor backend escrevendo uma ferramenta de linha de comando em Dart, ou um engenheiro de UX criando aplicações com Flutter, o desempenho do programa é essencial para o sucesso do seu projeto. Ferramentas de linha de comando devem minimizar a latência, e os apps devem ser responsivos e fluidos, sem frames perdidos. Como desenvolvedores, fazemos o nosso melhor para escrever código performático, mas às vezes não fica claro por que nosso código não tem o desempenho que esperávamos.
Rastrear problemas de desempenho em uma base de código pode ser uma tarefa assustadora. Há várias formas de escrever código Flutter que faz com que ele rode mais devagar do que deveria. Algumas são gritantemente óbvias, e outras são sutis e traiçoeiras. Por exemplo, talvez você tenha usado a API ou a estrutura de dados errada para uma determinada situação.
Este artigo percorre um estudo de caso simples que examina o desempenho de uma aplicação lenta de interface de linha de comando (CLI) em Dart. Você vai aprender sobre:
Profilers de CPU em geral e sua importância.
O profiler de CPU por amostragem que vem com o Dart e o Flutter.
Com esse novo entendimento sobre profiling de CPU, vamos depurar o desempenho do nosso programa. Faremos isso usando o CPU Profiler do Dart DevTools e a funcionalidade
UserTag do dart:developer para localizar o código ineficiente. Temos muita coisa para cobrir, então vamos começar!
Nota: O Dart DevTools também é chamado de Flutter DevTools, mas não deve ser confundido com o Chrome DevTools.
Estudo de caso: implementando grep em Dart
#Considere a seguinte aplicação CLI simples em Dart:
// filename: grep.dart
import 'dart:io';
/// Finds and prints all instances of [pattern] in the [file].
void grep(File file, String pattern) {
// Open the file and read its contents.
final lines = file.readAsLinesSync();
String output = '';
int lineNum = 1;
// Check each line to see if it matches `pattern`.
for (final line in lines) {
final matcher = RegExp(pattern);
if (matcher.hasMatch(line)) {
final foundMessage = '$lineNum:$line';
output += foundMessage;
}
lineNum++;
}
stdout.writeln(output);
}
void main(List<String> arguments) {
if (arguments.length != 2) {
print('Usage: dart grep.dart <path> <pattern>');
exitCode = 64;
return;
}
final path = arguments[0];
final pattern = arguments[1];
final file = File(path);
if (!file.existsSync()) {
stderr.writeln("Error: unable to open file '$path'");
exitCode = 64;
return;
}
grep(file, pattern);
}
O programa grep.dart implementa uma versão de uma ferramenta comum do Unix. Ele permite que os usuários pesquisem em arquivos a ocorrência de uma sequência de caracteres que corresponda a um padrão especificado. Por exemplo, dado um arquivo
names.txt contendo:
$ cat names.txt
Frank
Bob
Franny
June
Ben
Francis
Vamos encontrar todas as linhas que contêm a string 'Fran':
$ dart grep.dart names.txt 'Fran'
1:Frank
3:Franny
6:Francis
Excelente! Devemos esperar essa saída do grep. Dito isso, names.txt é um arquivo
pequeno. Vamos tentar encontrar todas as ocorrências de 'Hummingbird' em um documento de texto maior. E se executarmos o mesmo programa em um arquivo de 437.000 linhas e 147 MiB sobre beija-flores?
$ dart grep.dart hummingbird_encyclopedia.txt 'Hummingbird'
Hum… ele não termina, mesmo depois de dois minutos. Como o grep do Unix se comporta?
$ grep -n 'Hummingbird' hummingbird_encyclopedia.txt
16:'''Hummingbirds''' are [[bird]]s native to the…
22:Hummingbirds have the highest…
24:Hummingbirds split from their [[Sister taxon|sister group]]…
// Output continues
O grep do Unix pesquisou o arquivo inteiro e retornou todas as linhas que contêm Hummingbird
em cerca de 45 segundos. Claramente, há algo estranho no nosso código que deveríamos investigar. Mas como identificar a causa dos nossos problemas de desempenho? O
CPU Profiler que acompanha o Dart DevTools é um ótimo lugar para começar!
O que é um profiler de CPU?
#Ferramentas de profiling de CPU rastreiam onde um programa gasta o seu tempo durante a execução. Para oferecer a experiência de profiling de CPU mais eficiente em termos computacionais, a máquina virtual do Dart (VM), que executa aplicações CLI e Flutter em Dart, usa um profiler de CPU por amostragem. Quando usado com ferramentas como o Dart DevTools, você consegue identificar gargalos de desempenho em programas Dart.
Um profiler de CPU por amostragem adota uma abordagem estatística para coletar dados de desempenho da aplicação. Ele coleta amostras interrompendo as threads em intervalos regulares e tirando um retrato da pilha de chamadas atual e de outros estados de execução relevantes. Essas amostras podem ser processadas para obter insights sobre aproximadamente quanto tempo é gasto executando funções específicas e com que frequência as funções aparecem em diferentes pilhas de chamadas.
A frequência com que as amostras são coletadas é conhecida como taxa de amostragem e é medida em amostras por segundo (também chamadas de hertz ou Hz). A maioria dos profilers por amostragem tem taxas de amostragem de 1000 Hz ou mais. Taxas de amostragem mais altas resultam em perfis de CPU mais detalhados, às custas de maior sobrecarga de amostragem no processo alvo. Com taxas de amostragem razoáveis, os profilers de CPU por amostragem são eficientes e têm pouco ou nenhum impacto nas características de desempenho da aplicação perfilada. Como um bônus adicional, os dados coletados costumam ser menos custosos computacionalmente para processar na análise, quando comparados aos profilers de rastreamento (tracing).
Mergulho profundo: como funciona um profiler por amostragem?
#Esta seção entra em detalhes sobre como o profiler de CPU por amostragem da VM do Dart funciona. Você não precisa conhecer esses detalhes para analisar perfis de CPU. Se você não se importa com os detalhes técnicos dos profilers de CPU por amostragem, pule esta seção.
O profiler de CPU por amostragem da VM do Dart tem três componentes importantes: o interruptor de threads (thread interrupter), o coletor de amostras (sample collector) e o processador de amostras (sample processor).
Thread Interrupter
#O thread interrupter roda em uma thread dedicada e dispara a coleta de amostras de CPU em cada thread que a VM gerencia. O thread interrupter normalmente fica inativo, acordando apenas uma vez por intervalo de amostragem. Após cada intervalo de amostragem, o interruptor percorre a lista de threads, informando a cada uma que ela deve pausar e coletar uma amostra. O thread interrupter tem comportamentos ligeiramente diferentes em cada plataforma, por causa de detalhes específicos de cada sistema operacional.
Na maioria das plataformas que suportam controle de fluxo baseado em sinais
(Android e Linux), o sinal SIGPROF
é enviado a cada thread. Isso dispara uma interrupção
que invoca um signal handler registrado pelo profiler de CPU na thread alvo, que então coleta a amostra de CPU antes de retomar o seu trabalho.
Em outras plataformas que não suportam sinais (Windows e Fuchsia) ou que têm desempenho ruim em algumas situações ao usar SIGPROF (macOS e iOS), o thread interrupter usa chamadas de sistema para pausar e retomar explicitamente cada thread depois de coletar a amostra de CPU. Nesse caso, a coleta da amostra é feita na thread do thread interrupter, e não na thread que está sendo amostrada.
Coleta de amostras
#Depois que uma thread é interrompida, o profiler de CPU coleta uma amostra do estado de execução atual da thread. Cada amostra inclui metadados como:
identificadores de thread e de isolate
-
user tag ativa para a thread
timestamps de coleta
stack trace atual da thread amostrada
O stack trace coletado consiste em uma lista de program counters (PCs), que correspondem aos endereços de retorno de cada função Dart e nativa encontrada na pilha. Esses PCs são coletados por um processo conhecido como “percorrer a pilha” (walking the stack). Durante uma caminhada pela pilha, o stack walker usa o frame pointer (FP) do frame do topo e o layout conhecido de cada frame da pilha para encontrar e registrar o PC associado à função, bem como o FP do frame anterior. O stack walker repete esse processo, usando o FP do frame anterior como ponto de partida, até chegar ao fim da pilha, como mostrado na Figura 1.
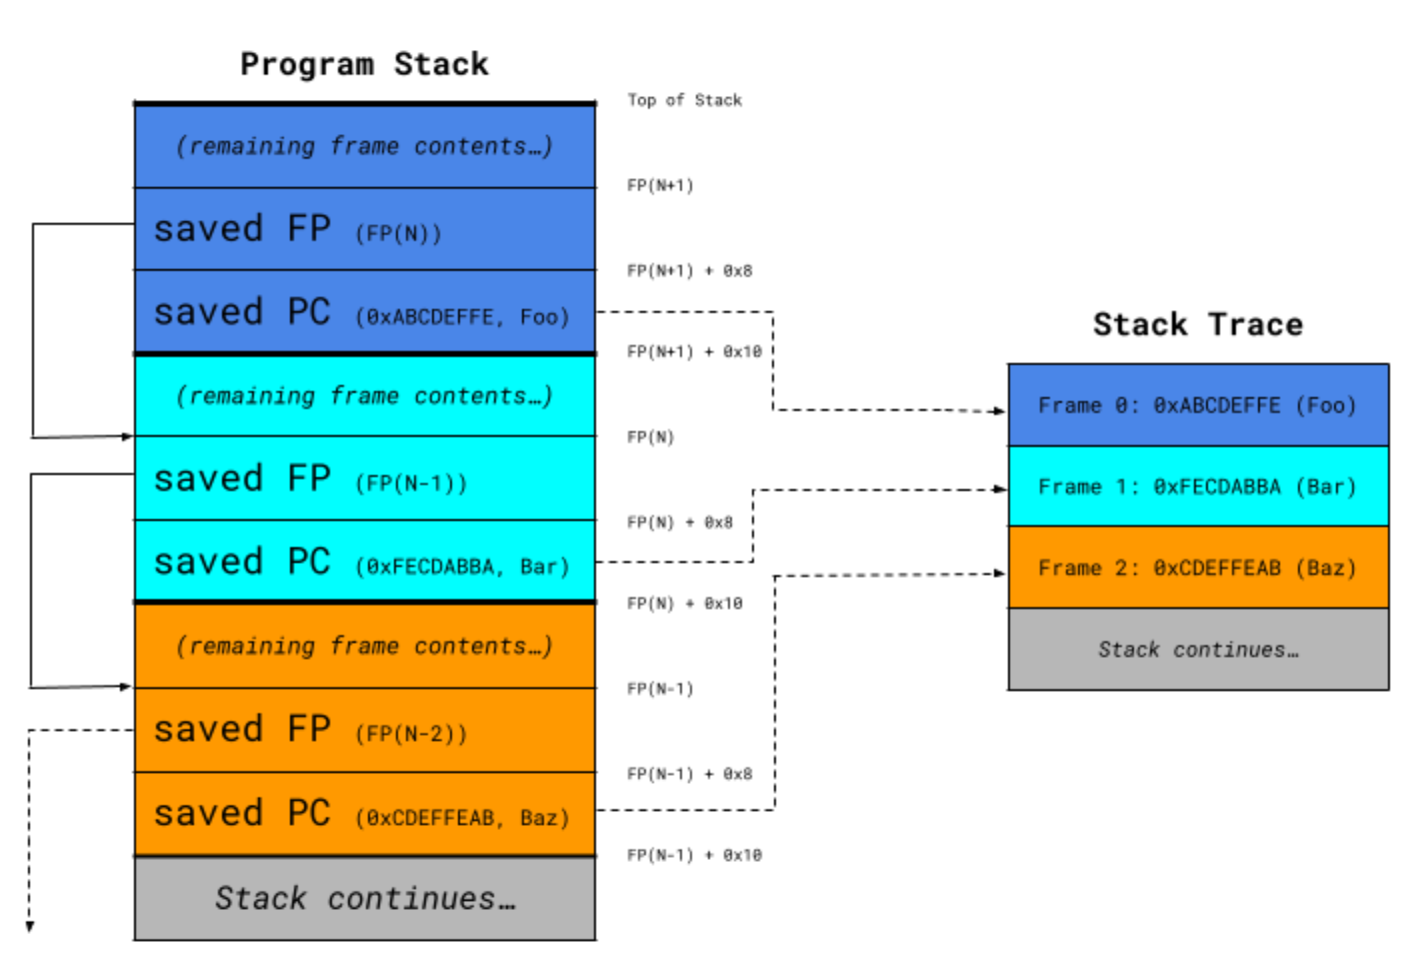
FP(N+1)
, obté
m
o
program
counter (PC)
do endereç
o FP(N+1) +
0x10
e
o
adiciona
ao
stack
trace
como
Frame 0.
Em seguida,
o
stack
walker
busca
o FP(N)
no endereç
o FP(N+1) + 0x8,
repetindo
o
mesmo
procedimento
com FP(N)
para
buscar
os
detalhes
do
Frame 1.
Cada amostra coletada é armazenada no buffer de amostras da VM, um buffer circular que pode armazenar uma quantidade limitada de amostras de CPU. Isso permite que a VM evite alocações adicionais em tempo de execução, que podem prejudicar o desempenho ou causar coisas ruins se feitas dentro do signal handler.
O tamanho do buffer de amostras é fixo em tempo de execução e, quando fica cheio, as amostras antigas são sobrescritas pelas novas pelo profiler. A velocidade com que o buffer de amostras enche depende da taxa de amostragem e da profundidade média da pilha de cada amostra. Por exemplo, taxas de amostragem mais altas e pilhas mais profundas fazem o buffer dar a volta mais rapidamente. No DevTools, os desenvolvedores podem controlar a velocidade com que o buffer de amostras dá a volta, escolhendo entre taxas de amostragem baixa (1000 Hz), média (4000 Hz) e alta (20.000 Hz).
Processamento de amostras
#Quando um cliente envia uma requisição de perfil de amostras de CPU pelo protocolo do serviço da VM, o profiler de CPU precisa processar as amostras coletadas antes de enviá-las ao cliente. O profiler:
-
Percorre o buffer de amostras, usando filtros para recuperar apenas as amostras do isolate e do período de tempo especificados pelo cliente.
-
Simboliza, ou seja, mapeia PCs para nomes de função, cada frame de pilha do conjunto de amostras.
Serializa todo o buffer de amostras processado para JSON.
Envia o JSON de volta ao cliente.
Mesmo depois do processamento feito pelo profiler, a resposta de amostras de CPU é de baixo nível e precisa de processamento adicional pelas ferramentas do desenvolvedor para ser útil. Por exemplo, o Dart DevTools pode converter a lista de amostras de CPU em várias representações estruturais que permitem identificar funções caras (Bottom Up) e caminhos de chamada custosos (Call Tree e CPU Flame Chart), além de inspecionar estatísticas de chamadores e chamados (Method Table) para métodos individuais.
Usando o Dart DevTools para perfilar aplicações Dart e Flutter
#
Agora que você já conhece o que são os profilers de CPU por amostragem e como funcionam, vamos depurar o desempenho da nossa implementação do
grep. Vamos executar o código novamente com --observe e abrir a aba CPU Profiler do Dart DevTools:
Nota: Você não precisa usar a flag --observe ao testar um app Flutter no DevTools.
$ dart — observe grep.dart hummingbird_encyclopedia.txt 'Hummingbird'
The Dart VM service is listening on http://127.0.0.1:8181/omxEtsCtW9k=/
The Dart DevTools debugger and profiler is available at: http://127.0.0.1:8181/omxEtsCtW9k=/devtools?uri=ws://127.0.0.1:8181/omxEtsCtW9k=/ws
// At this point, the terminal hangs with no output.
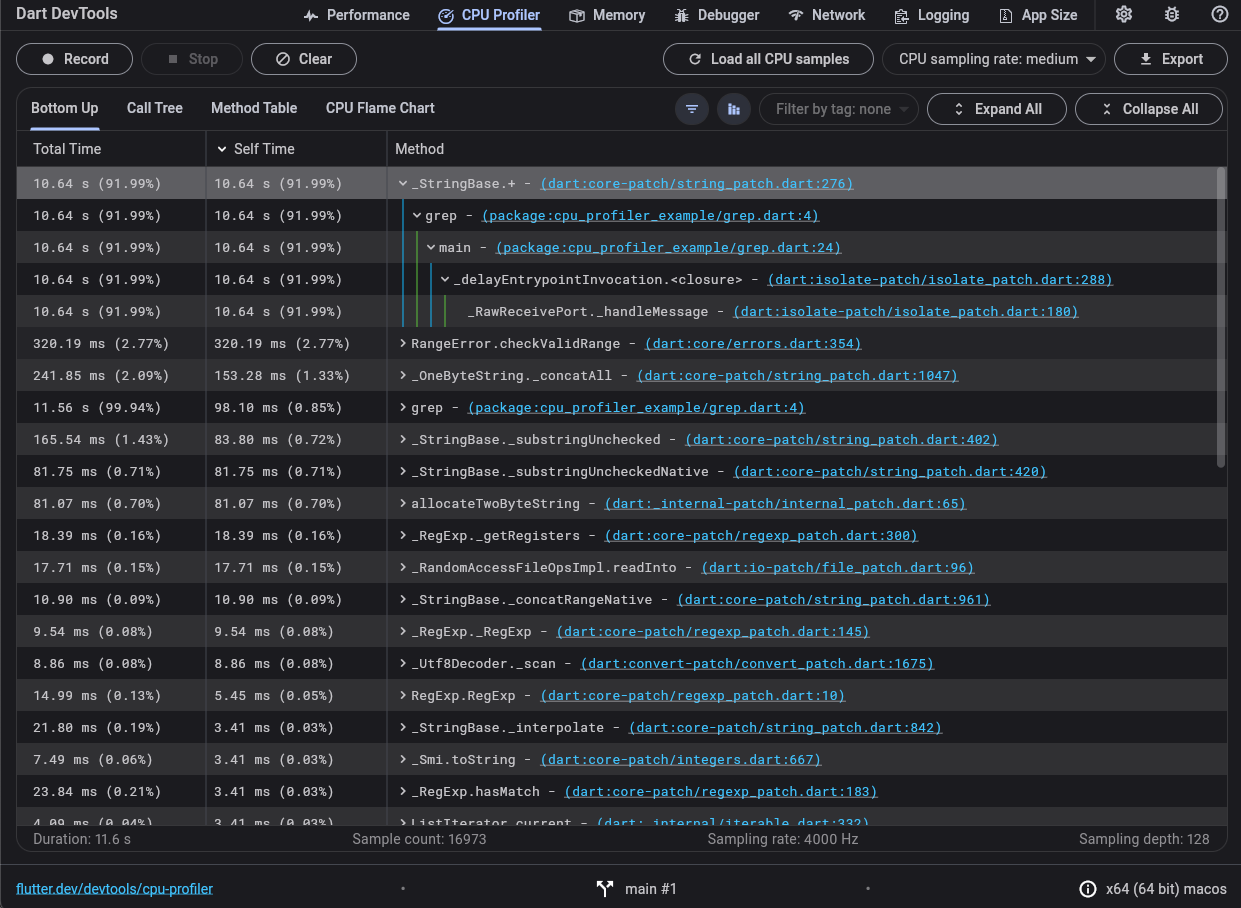
Puxa! De todas as amostras coletadas em um período de 11,6 segundos, o isolate gastou mais de 90% do seu tempo de CPU executando
_StringBase.+. É provável que isso esteja relacionado aos nossos problemas de desempenho, mas pode não ser óbvio qual bloco de código na nossa função
grep é a origem da lentidão. Felizmente, podemos restringir ainda mais a localização das chamadas caras a
_StringBase.+ usando user tags.
Categorizando amostras de CPU com User Tags
#
Quando o profiler de CPU do Dart interrompe uma thread para coletar uma nova amostra, ele registra o user tag atual definido para o isolate. A biblioteca
dart:developer
fornece a classe UserTag, que permite especificar e definir tags personalizadas para trechos de código que você quer perfilar.
Para entender melhor onde estamos gastando tempo na nossa implementação do grep, podemos instrumentar a função com user tags:
// filename: grep.dart
import 'dart:developer';
import 'dart:io';
/// Finds and prints all instances of [pattern] in the [file].
void grep(File file, String pattern) {
final defaultTag = getCurrentTag();
final fileReadTag = UserTag('File Read');
final textMatchTag = UserTag('Text Matching');
final printTag = UserTag('Print Output');
// Set the 'File Read' tag as the current user tag.
fileReadTag.makeCurrent();
// Open the file and read its contents.
final lines = file.readAsLinesSync();
// Set the 'Text Matching' tag as the current user tag.
textMatchTag.makeCurrent();
String output = '';
int lineNum = 1;
// Check each line to see if it matches `pattern`.
for (final line in lines) {
final matcher = RegExp(pattern);
if (matcher.hasMatch(line)) {
final foundMessage = '$lineNum:$line';
output += foundMessage;
}
lineNum++;
}
// Set the 'Print Output' tag as the current user tag.
printTag.makeCurrent();
stdout.writeln(output);
// Reset the user tag to the tag set when grep was invoked.
defaultTag.makeCurrent();
}
Agora, vamos executar nosso programa novamente e abrir o CPU Profiler. Para ver o perfil categorizado, selecione a opção Group by: User Tag no menu suspenso:
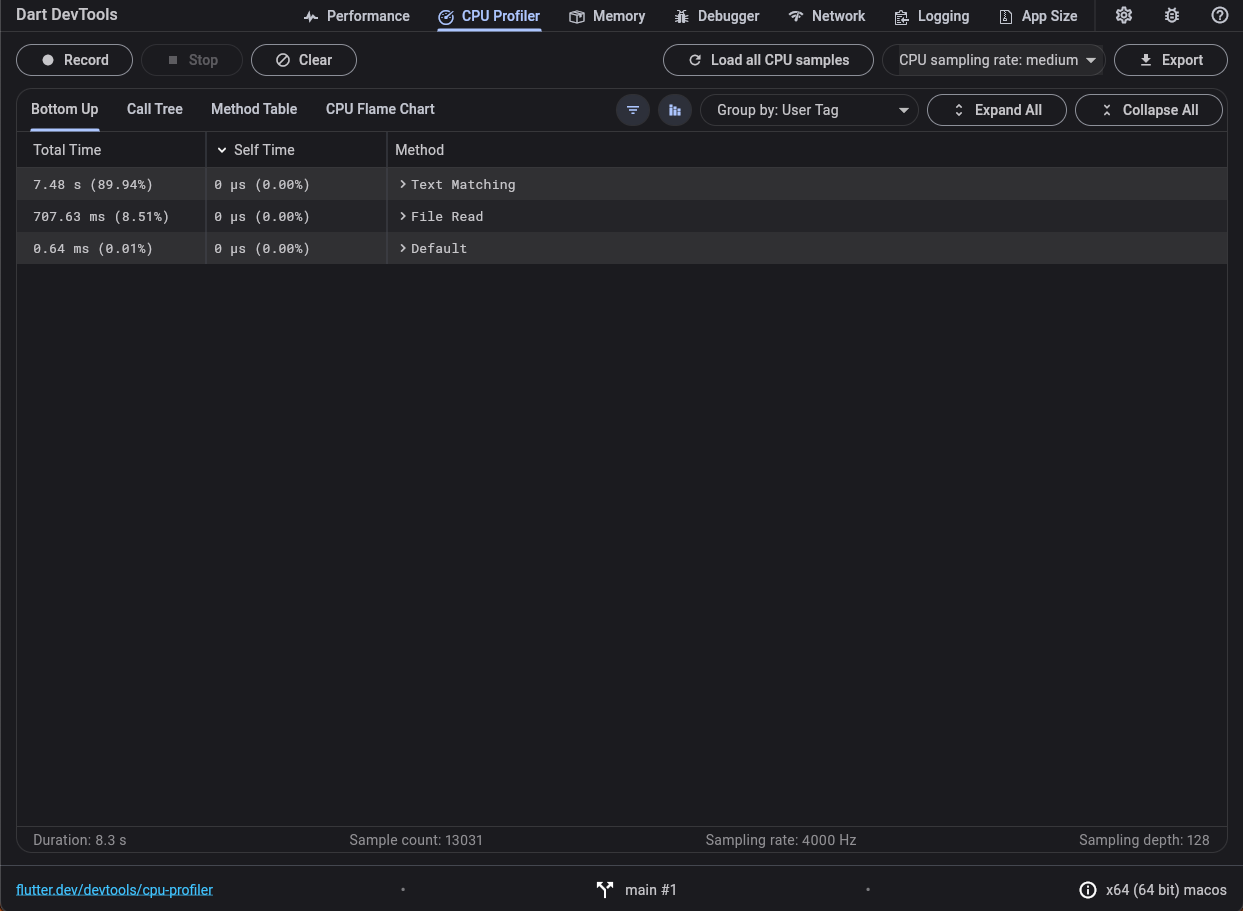
Quando expandimos a tag Text Matching, confirmamos que o método _StringBase.+
é chamado no nosso loop de correspondência de texto:
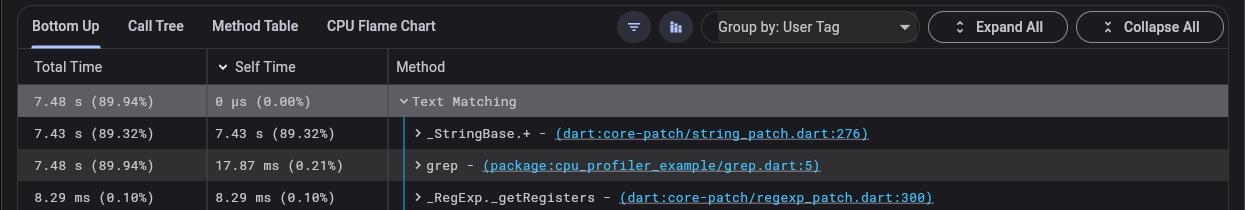
Com essa informação, deveríamos conseguir olhar mais de perto para o nosso código e identificar o problema:
  // Set the ‘Text Matching’ tag as the current user tag.
  textMatchTag.makeCurrent();
  String output = '';
  int lineNum = 1;
  // Check each line to see if it matches `pattern`.
  for (final line in lines) {
    final matcher = RegExp(pattern);
    if (matcher.hasMatch(line)) {
      final foundMessage = '$lineNum:$line';
      // Ahah! This is our call to _StringBase.+!
      output += foundMessage;
    }
    lineNum++;
  }
Aí está! Cometemos o clássico erro de concatenar conteúdo a uma String
várias vezes, em vez de usar um StringBuffer. Concatenar conteúdo a uma
String cria uma nova string para armazenar o resultado do método _StringBase.+. Como resultado, copiamos
output + foundMessage para uma nova string toda vez que encontramos uma correspondência.
À medida que o output fica mais longo, concatenar dados a ele fica mais caro, exigindo O(m*n)
para realizar as cópias, onde m é o número médio de caracteres em uma correspondência e
n é o número total de caracteres na string final. Se usarmos um StringBuffer, não copiamos
output toda vez que concatenamos a ele; em vez disso, juntamos as correspondências em uma única operação
O(n) no final da função.
Agora que nosso app usa StringBuffer.writeln
em vez de concatenar a uma String, vamos dar uma olhada na nossa função:
// filename: grep.dart
import ‘dart:developer’;
import 'dart:io';
/// Finds and prints all instances of [pattern] in the [file].
void grep(File file, String pattern) {
final defaultTag = getCurrentTag();
final fileReadTag = UserTag(‘File Read’);
final textMatchTag = UserTag(‘Text Matching’);
final printTag = UserTag(‘Print Output’);
// Set the ‘File Read’ tag as the current user tag.
fileReadTag.makeCurrent();
// Open the file and read its contents.
final lines = file.readAsLinesSync();
// Set the ‘Text Matching’ tag as the current user tag.
textMatchTag.makeCurrent();
final output = StringBuffer();
int lineNum = 1;
// Check each line to see if it matches `pattern`.
for (final line in lines) {
final matcher = RegExp(pattern);
if (matcher.hasMatch(line)) {
final foundMessage = '$lineNum:$line';
// Add the match to the buffer without creating a copy.
output.writeln(foundMessage);
}
lineNum++;
}
// Set the ‘Print Output’ tag as the current user tag.
printTag.makeCurrent();
// output.toString() concatenates each entry in the buffer
// into a new String, only performing a single allocation of
// size `output.length`.
stdout.writeln(output);
// Reset the user tag to the tag set when grep was invoked.
defaultTag.makeCurrent();
}
Vamos executar o teste novamente para ver se há alguma melhoria:
$ dart grep.dart hummingbird_encyclopedia.txt 'Hummingbird'
16:‘’’Hummingbirds’’’ are [[bird]]s native to the…
22:Hummingbirds have the highest…
24:Hummingbirds split from their [[Sister taxon|sister group]]…
// Output continues
Usando StringBuffer, conseguimos encontrar todas as ocorrências de 'Hummingbird'
em cerca de 45 segundos. Isso é muito melhor e quase igual à implementação grep
do Unix! Vamos dar mais uma olhada no CPU profiler para ver se conseguimos melhorar o desempenho ainda mais:
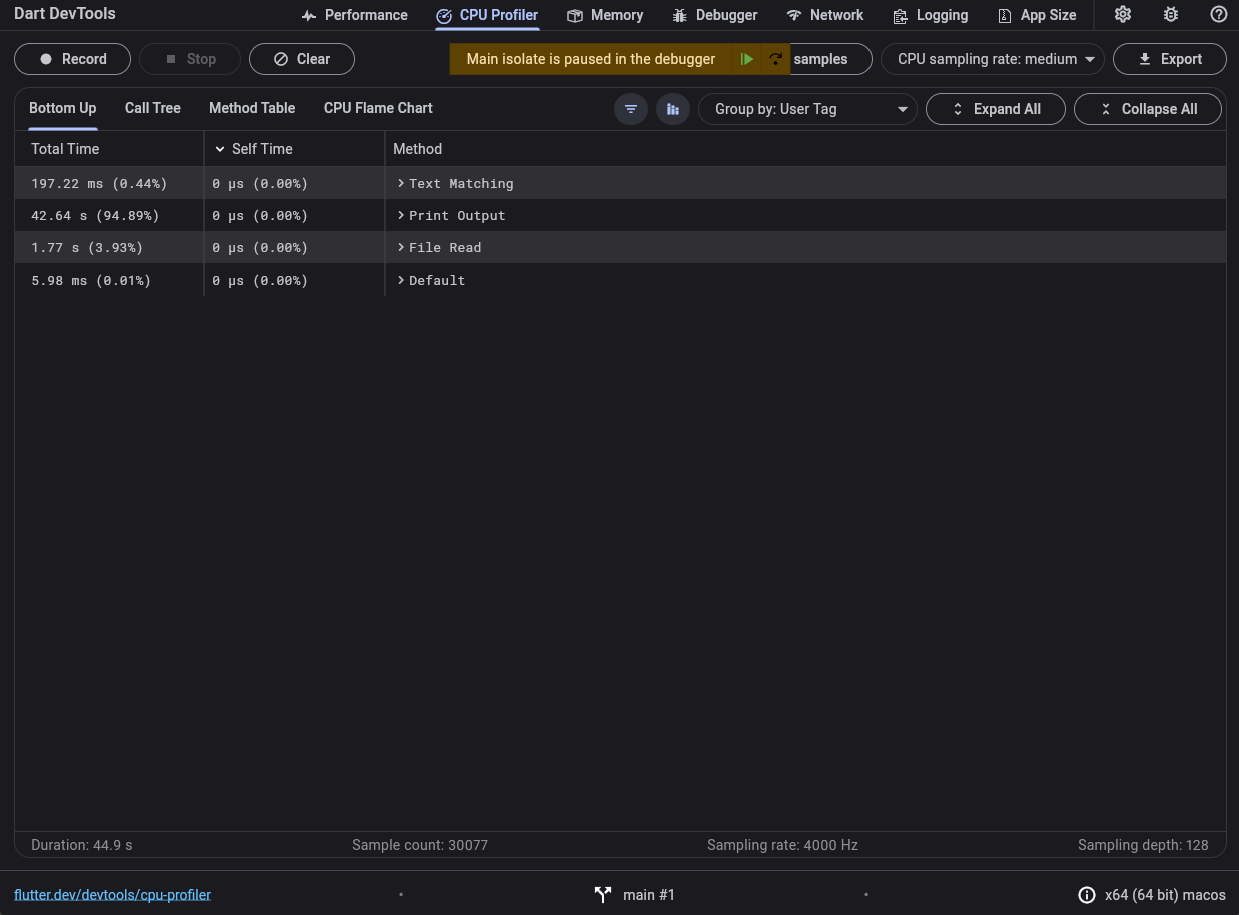
Uma olhada rápida no perfil nos diz que passamos a maior parte do tempo imprimindo as correspondências, e que a busca em si leva só cerca de 200 ms. Devemos focar no código que cai sob a tag
'Print Output':
  // Set the ‘Print Output’ tag as the current user tag.
  printTag.makeCurrent();
  // output.toString() concatenates each entry in the buffer
  // into a new String, only performing a single allocation of
  // size `output.length`.
  stdout.writeln(output);
Não parece haver muito o que fazer, já que estamos fazendo apenas uma única chamada a stdout.writeln, um membro da biblioteca central
dart:io. Olhando para o
CPU flame chart no profiler, vemos que esse código está no SDK e que não conseguimos mais ganhos de desempenho no nosso código.
Com isso, terminamos!
Resumo
#Conquistamos muita coisa desde o início deste artigo. Nós:
Escrevemos uma ferramenta
grepsimples em Dart.Identificamos que nosso programa tinha um desempenho ruim.
-
Aprendemos sobre profilers de CPU e exploramos o profiler de CPU por amostragem da VM do Dart.
-
Usamos o CPU Profiler do Dart DevTools para identificar e corrigir os problemas de desempenho do nosso programa.
Ter um bom entendimento das ferramentas de desempenho é uma habilidade importante e, como mostramos neste artigo, pode ajudar você a identificar problemas de desempenho potencialmente sutis no seu código. O CPU Profiler é apenas uma das muitas ferramentas que acompanham o Dart DevTools e que podem ajudar você a entender melhor o comportamento e o desempenho das suas aplicações CLI e Flutter em Dart.
Em artigos futuros, vamos explorar outras formas de usar o Dart DevTools para depurar e otimizar seus apps, incluindo:
-
Analisar o uso de memória pela tela Memory
-
Examinar as linhas do tempo de execução pela tela Performance
-
Inspecionar o tráfego HTTP pela tela Network
Até lá, bom código!
Se você se sentir inclinado, siga-me no GitHub para acompanhar meu trabalho em Flutter e na máquina virtual do Dart, além dos meus outros projetos pessoais.
Mais do Dart
Trazendo construtores primários para o Dart
Um olhar por dentro das decisões de design, dos trade-offs e do açúcar sintático por trás da adição de construtores primários no Dart 3.13.

A história da interop com JS no Dart
O suporte ao Wasm acaba de chegar ao Flutter beta atual, graças a um marco empolgante de interop com JavaScript alcançado no Dart 3.3. Para celebrar…
